Wie wir für alle Mitarbeitenden bei Notion einen persönlichen Data Scientist entwickelt haben

Von David Thomas
Technischer Engineering Manager, Dateninfrastruktur
Datenanfragen bei Notion stießen früher immer auf denselben Engpass: die Zeit unseres Datenteams. Jemand hat einen Beitrag in Slack veröffentlicht, danach sichtete ein Data Scientist die Anfrage, suchte die richtige Quelle, überprüfte die Definition, schrieb die Abfrage und erklärte das Ergebnis. Selbst Routinefragen konnten Tage dauern.
Wir haben Data Scout, unseren internen Daten-Agenten, entwickelt, um diesen Prozess zu verkürzen. Jetzt kann jeder bei Notion eine Frage in einfacher Sprache stellen und eine Antwort aus unseren verwalteten Daten in Snowflake erhalten. Innerhalb von zwei Monaten sanken die wöchentlichen Anfragen an das Datenteam um etwa 80 Prozent. Fragen, die früher in einer Warteschlange lagen, dauern jetzt nur noch wenige Minuten.
Diese Veränderung hat unserem Datenteam Zeit zurückgegeben. Anstatt wiederholt dieselben Zahlen abzurufen oder dieselbe Analyse in verschiedenen Varianten durchzuführen, können sie sich auf tiefergehende Arbeit konzentrieren, die ihr Urteilsvermögen und ihre Expertise erfordert.
Heute nutzt etwa die Hälfte der Notion-Mitarbeitenden Data Scout. Aber die größere Veränderung liegt darin, wie Personen arbeiten. Teams bitten den Agent, Zahlen abzurufen, während sie Recherchen durchführen, Berichte erstellen und sich auf Meetings vorbereiten. „Hast du Data Scout gefragt?“ ist zu einer gängigen Frage geworden. Personen müssen kein Ticket mehr eröffnen und warten, bevor sie Daten in einen Entscheidungsprozess einbeziehen.
Ich gehöre zu den Datenentwickler/-innen, die Data Scout mitentwickelt haben. Ich habe diesen Text für Führungskräfte geschrieben, die verstehen wollen, warum wir ihn entwickelt haben und was sich geändert hat, sowie für meine Kolleginnen und Kollegen aus der Datenentwicklung, die wissen wollen, wie wir ihn gebaut haben. Ich beginne damit, wie Teams Data Scout heute nutzen, und gehe dann auf die technischen Entscheidungen und Kompromisse dahinter ein.
Oh-oh! Offenbar verhindert dein Werbeblocker, dass das Video abgespielt wird.
Schau es dir bitte auf YouTube an
Wie Teams bei Notion den Data Scout nutzen
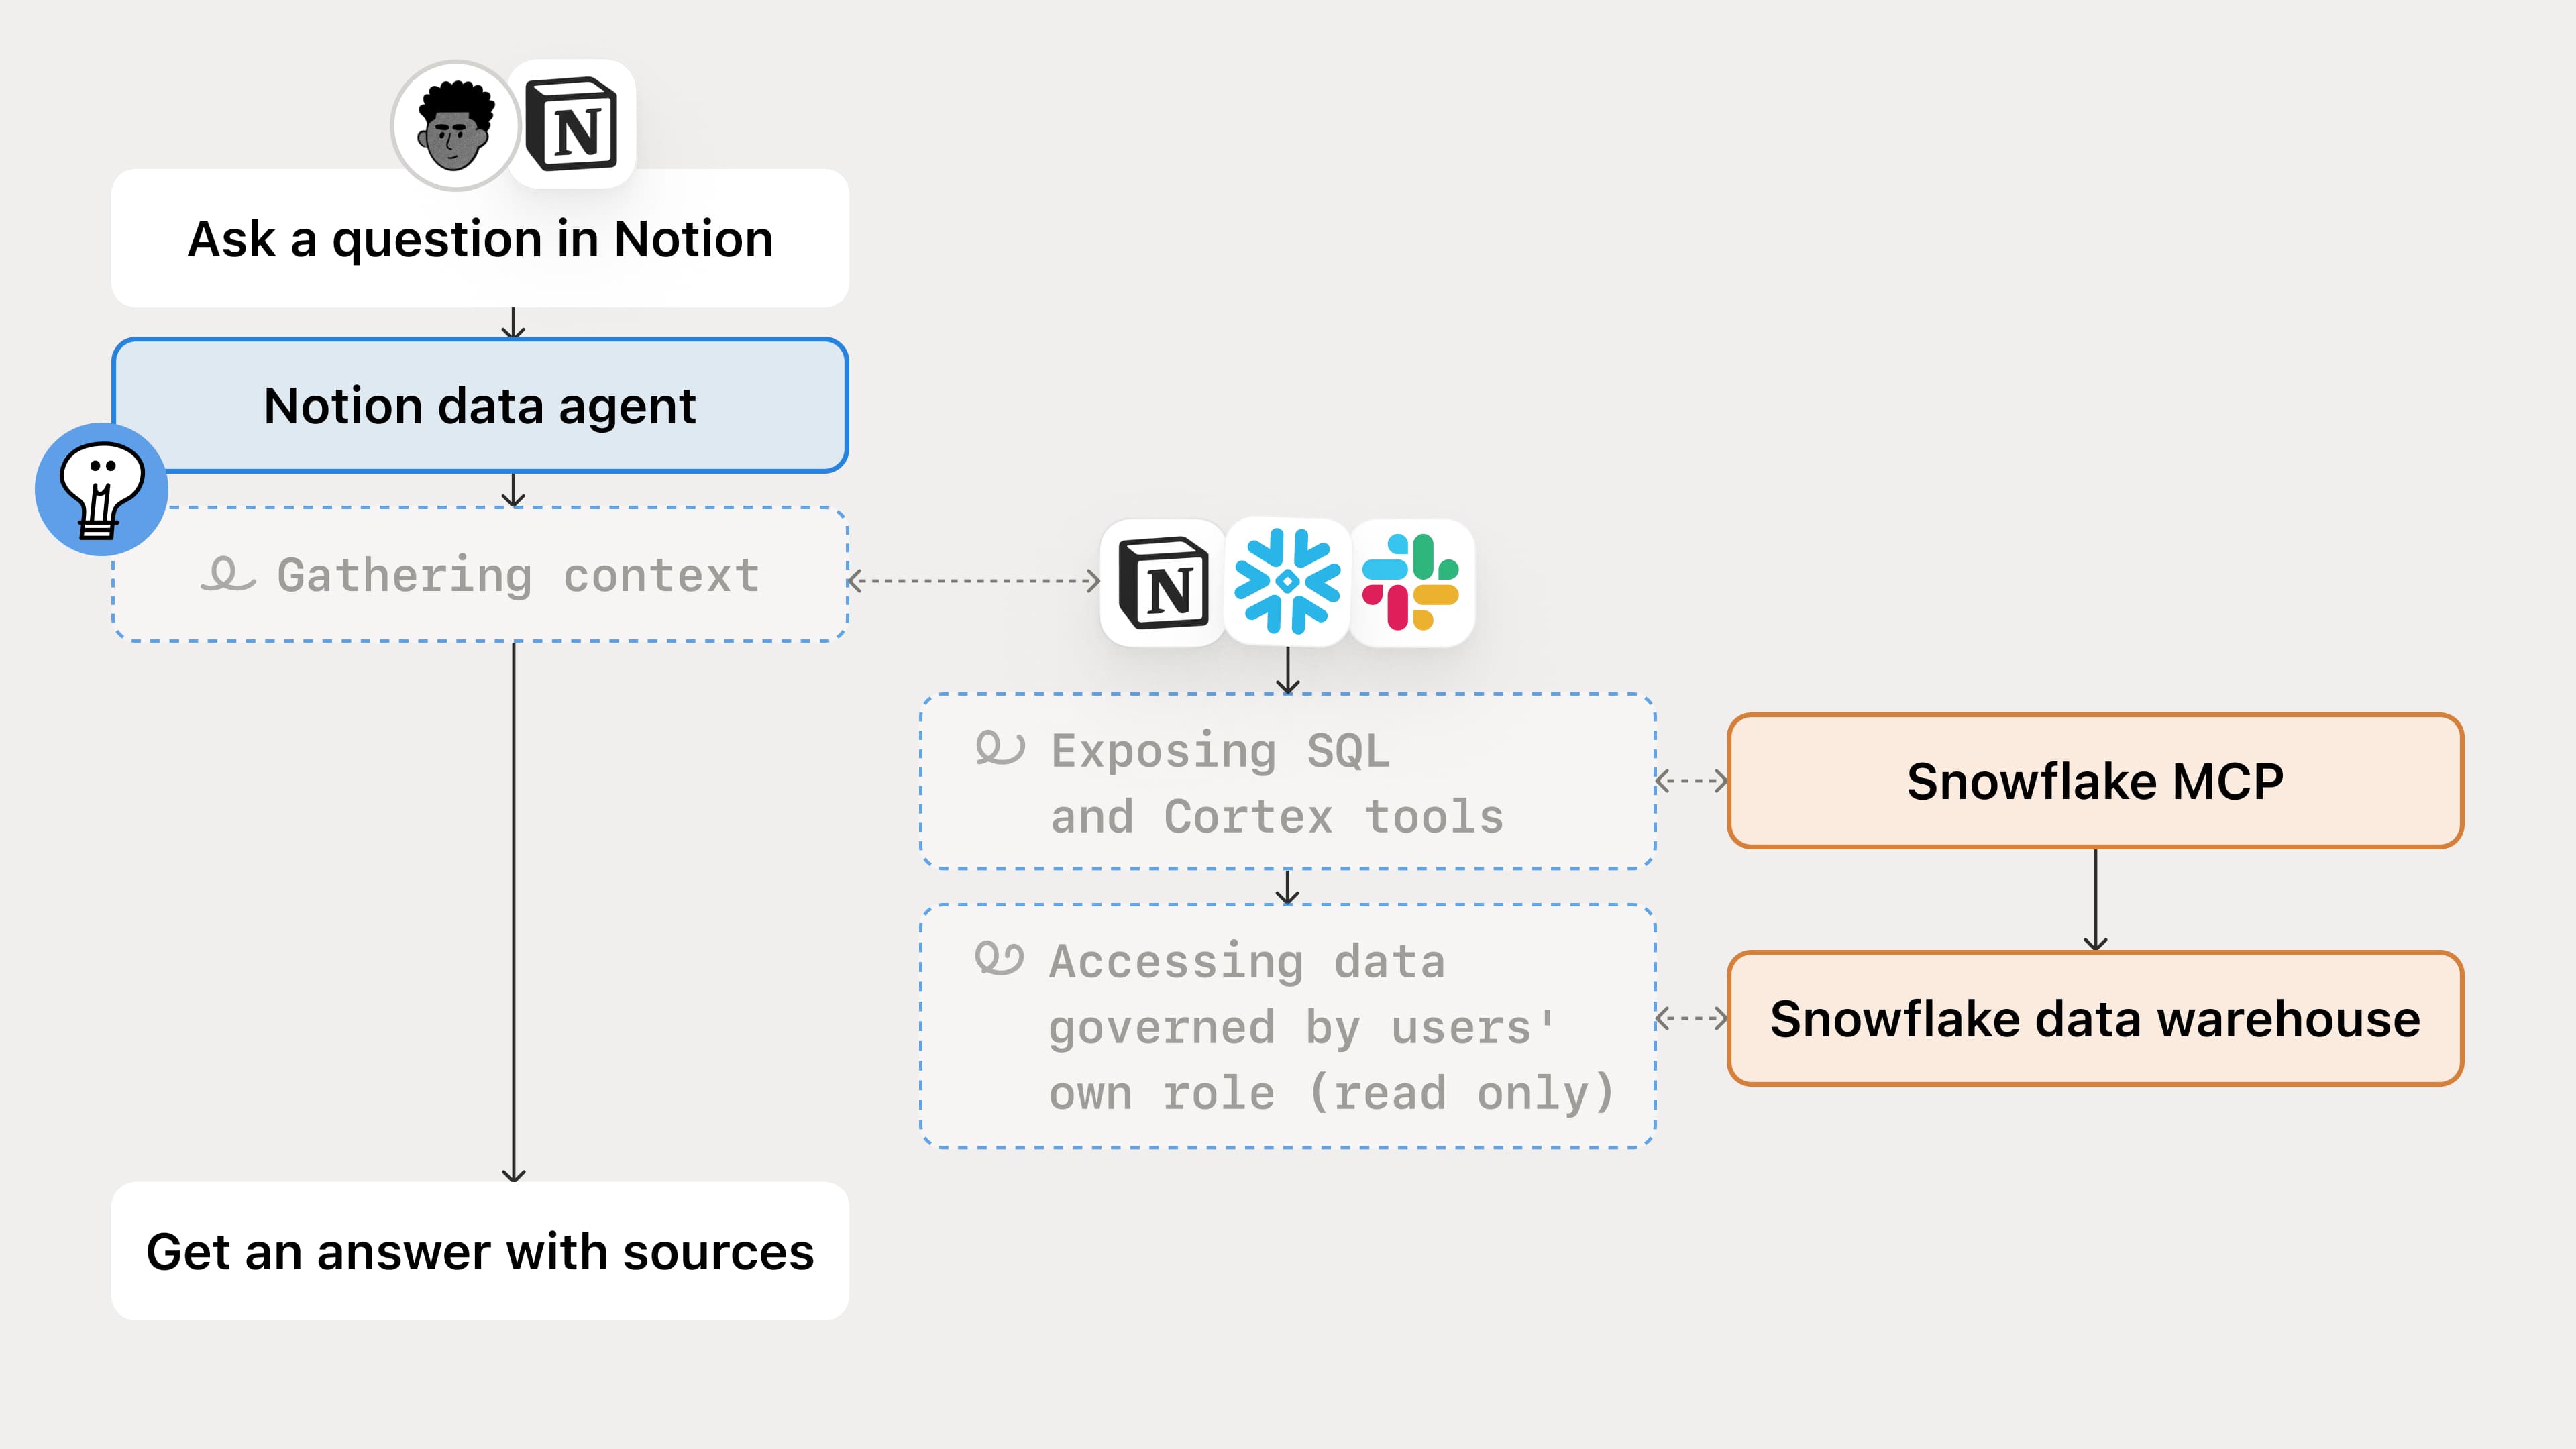
Data Scout verbindet verwaltete Daten in Snowflake mit Unternehmenswissen in Notion und verbundenen Quellen wie Slack. Snowflake erzwingt Datenberechtigungen, während Notion den Zugriff auf den Agent und seine Tools steuert und den Geschäftskontext liefert, der zum Verständnis jeder Frage erforderlich ist.
Diese geteilte Grundlage und das Berechtigungsmodell ermöglichen es vielen Teams, denselben Agent für unterschiedliche Entscheidungen zu nutzen: Der Vertrieb kann sich über die Nutzung von Kundenkonten informieren, das Produktteam kann Abbrüche im Onboarding untersuchen und das Customer-Experience-Team kann das Support-Volumen analysieren.
Wir haben Data Scout mit einer Stichprobe von 200 echten Fragen getestet. Hier sind einige der häufigsten Themen:
Team | Wiederkehrende Arbeit | Repräsentative Frage |
|---|---|---|
Vertrieb | Kontonutzung, KI-Einführung, Plätze, ARR, Pipeline und Besitz | Wie nutzt dieses Konto Notion und KI in seinen Workspaces? |
Entwicklung | Produkt- und KI-Verhalten, Identitätsabfragen und Datenvalidierung | Welche Agenten oder Workspaces blieben aktiv und wo hat sich das Verhalten geändert? |
Customer Experience | Ticket-Volumen, Erstantwortzeit, CSAT und Kundenkontext | Was beeinflusst das Volumen und die Antwortzeit dieser Support-Warteschlange? |
Produkt | Nutzung von Funktionen, Onboarding, Aktivierung und Conversion | Wo steigen Personen aus dem Onboarding aus und wie unterscheidet sich das je nach Kohorte? |
Marketing | Ansprache von Zielkonten, Nutzung durch Kunden, Kampagnen und Pipeline | Welche Zielkonten nutzen bereits Notion-KI und worauf sollten wir unsere Kontaktaufnahme konzentrieren? |
Ein Beispiel aus unserem GTM-Team: die Nutzung durch ein Konto verstehen
Um zu zeigen, wie diese Teile zusammenpassen, begleiten wir ein GTM-Teammitglied bei der Vorbereitung auf eine Kundenverlängerung.
Sie fragen: „Nimmt die KI-Nutzung in diesem Konto zu?“ Eine nützliche Antwort erfordert die richtige Nutzungskennzahl und die richtige Abgrenzung des Kontos sowie die Ziele des Kunden und die geplante Einführung von KI. Data Scout kombiniert Nutzungsdaten aus Snowflake mit Kontonotizen und früheren Meetings in Notion, um zu zeigen, ob die Nutzung dem Plan des Kunden entspricht.
Die erste Antwort führt oft zu einer weiteren Frage: „Welche Teams treiben den Anstieg der KI-Nutzung voran?“ oder „Kommt dieses Wachstum von neuen Nutzern oder durch eine intensivere Nutzung bei bestehenden Nutzern?“ Anstatt für jede Anschlussfrage eine neue Datenanfrage zu stellen, kann unser Account Manager in der Kontoverwaltung tiefer in die Daten in derselben Unterhaltung einsteigen und mit einem vollständigen Bild der Veränderungen zum bevorstehenden Verlängerungsmeeting kommen.
Vom einzelnen Daten-Agent zu wiederkehrenden und spezialisierten Workflows
Diese Art von Ad-hoc-Fragen war nur der Anfang. Im Laufe der Zeit entwickelten Teams Agents, die sich über die geteilte MCP-Verbindung von Data Scout mit dem Dienst verbinden und dessen kontrollierten Datenzugriff sowie den Unternehmenskontext wiederverwenden. Daraus entstanden zwei weitere Arbeitsmuster:
Wiederkehrende Analysen: Data Scout Reporter verbindet sich mit Data Scout, um gespeicherte Berichtsdefinitionen in geplante Berichte in Notion und Slack umzuwandeln, sodass Teams dieselben Kennzahlen im Zeitverlauf verfolgen können, ohne die Analyse jede Woche neu ausführen zu müssen.
Domänenspezifisches Fachwissen: Teams entwickelten spezialisierte Agents mit detaillierteren Anweisungen für ihre eigenen Workflows und nutzten dabei weiterhin die kontrollierten Daten und den Kontext von Data Scout.
Data Scout ist der am häufigsten genutzte interne Agent von Notion, aber diese verwandten Agents sind inzwischen ebenfalls beliebt. An Ersteren wendet man sich mit einer Ad-hoc-Frage. Letztere übertragen diese Grundlage auf wiederholbare, teamspezifische Workflows. Doch als immer mehr Teams und Agenten dieselbe Grundlage nutzten, wurde es schwieriger, die Verlässlichkeit ihrer Antworten zu sichern.
Warum funktionierendes SQL nicht ausreicht
Wir haben festgestellt, dass eine Abfrage sauber ausgeführt werden kann und dennoch die falsche Frage beantwortet. Der schwierige Teil bestand darin, die geschäftlichen Zusammenhang beizubehalten, während eine Frage zu einer Abfrage und die Abfrage zu einer Antwort wurde. Nehmen wir die Frage zur KI-Nutzung. Selbst wenn das SQL funktioniert, kann die Antwort auf vier Arten falsch sein:
Die Bedeutung kann falsch sein. Das Zählen von Workspace-Mitgliedschaften anstelle von Personen kann die Nutzung höher erscheinen lassen, wenn jemand zu mehreren Workspaces gehört.
Das Routing kann falsch sein. Der Agent findet möglicherweise eine plausible Tabelle oder Verbindung, ohne die gepflegte Definition und die erforderlichen Filter zu finden.
Die Messung kann falsch sein. Eine Änderung in der Art und Weise, wie wir die Nutzung erfassen, oder eine Korrektur historischer Daten kann die Nutzung steigen oder sinken lassen, obwohl die Kunden ihr Verhalten gar nicht geändert haben.
Die Interpretation kann falsch sein. Selbst eine korrekte Zahl kann falsch gedeutet werden. Eine scheinbar stagnierende KI-Nutzung kann durchaus im Plan liegen, wenn der Kunde KI teamweise einführt. Dieser Kontext findet sich in den Notizen zum Konto und zu vergangenen Meetings in Notion, nicht in Snowflake.
Die Lektion, die wir gelernt haben, war klar: Kuratierter Kontext ist genauso wichtig wie die Verbindung selbst. Der Zugriff auf Daten sagt dem Agenten nicht, welcher Definition er vertrauen soll, welche Quelle er verwenden soll oder was ein Ergebnis für das Unternehmen bedeutet. Für dieses Wissen ist eine verantwortliche Person sowie ein Verfahren erforderlich, um es aktuell zu halten.
Daten-Agents bauen und verwalten
Wir setzen auf kontrollierten Agent- und Datenzugriff, geteilten Datenkontext und klare Anweisungen. Zusammen legen diese die Berechtigungen des Agents, das von ihm verwendete Wissen und den Prozess fest, dem er folgt.

Diese Säulen allein machen Antworten nicht zuverlässig. Wir validieren die Ergebnisse, überprüfen, wie der Agent sie erreicht hat, und aktualisieren die Anleitung, wenn sich Daten und Geschäft ändern.
Den Agent und seinen Datenzugriff steuern
Notion und Snowflake steuern verschiedene Teile des Workflows. Notion verwaltet den Zugriff auf den Workspace und die verfügbaren Tools, während Snowflake Datenberechtigungen für die Identität erzwingt, die die Abfrage ausführt.
Benutzer können eine Verbindung zu Snowflake MCP herstellen – über Custom Agents oder ihren Notion Agent. Unabhängig vom Einstiegspunkt muss sich jeder Benutzer mit seinen eigenen Anmeldeinformationen bei Snowflake anmelden. Auf diese Weise werden Abfragen unter der authentifizierten Snowflake-Identität der jeweiligen Person ausgeführt, und die Antworten spiegeln deren individuellen Datenzugriff wider.
Snowflake-Datenkontrollen setzen Rollen und Berechtigungen durch sowie, sofern konfiguriert, Maskierungsrichtlinien und Richtlinien auf Zeilenebene. So bleiben die Berechtigungen auf die Daten und Aktionen beschränkt, die der Workflow benötigt.
Die Abfrage des Accont Managers muss die Datenberechtigungen der Verbindung berücksichtigen, und ihre Ergebnisse müssen für den Bericht oder Kanal geeignet sein, in dem sie geteilt werden. Ein Agent kann schwer auffindbare Daten zutage fördern, umgeht aber keine Zugriffskontrollen.
Daten und Geschäftskontext verbinden
Geteilter Datenkontext hilft Agents, dieselben Definitionen und Hinweise zu Quellen zu verwenden. Notion ist unser Hub für Geschäftskontext, mit Plänen, Entscheidungen und Kundenwissen, das der Agent nutzen kann, um besser zu verstehen, was die Frage bedeutet.
Wir halten die Verantwortlichkeiten getrennt, selbst wenn die Referenzen zusammen gespeichert sind:
Datenkontext steuert die Berechnung: Metriken, Quellen, Granularität, Verknüpfungen, erforderliche Filter und Aktualität.
Geschäftskontext erklärt Ziele, Unternehmensterminologie, Kundenhistorie und Ereignisse, die bei der Interpretation des Ergebnisses helfen können.
Routing-Anleitung wählt die richtigen genehmigten Quellen, Verbindungen und Tools aus und findet dann den relevanten Kontext. Sie kann mehrere Snowflake-Verbindungen oder verschiedene Plattformen umfassen, nicht nur Tabellen innerhalb eines Data Warehouse.
Wir verwenden eine Notion-Datenbank als gemeinsamen Index für Definitionen, Schemata, Fähigkeiten und bekannte Datenänderungen. Jede Zeile ist auch eine Seite. Ihre Eigenschaften helfen dem Agent, relevante Anleitungen zu finden, während ihr Inhalt die Definitionen, Verfahren, Vorbehalte oder Referenzen enthält, die der Agent verwenden muss.
Der Agent liest die ausgewählten Seiteninhalte und folgt relevanten Referenzen, anstatt die gesamte Datenbank zu laden. Metadaten helfen ihm, den richtigen Kontext zu finden, ersetzen diesen Kontext jedoch nicht. Wenn eine Definition woanders gespeichert ist, verweist der Eintrag auf die gepflegte Quelle, anstatt sie zu kopieren.
Wir haben uns für Notion entschieden, weil der Kontext dort neben den Plänen, Entscheidungen und dem Kundenwissen liegt, die unsere Teams bereits pflegen. Der Agent kann eine Metrikdefinition und die zugehörigen Kontonotizen im selben Workspace lesen. Besitzer/-innen können vertraute Seiten mit den bestehenden Berechtigungen von Notion bearbeiten und teilen. Agents finden Einträge über deren Eigenschaften und lesen dann die Seiteninhalte. Wir haben versucht, alle Anleitungen für einen schnelleren Abruf in Datenbankeigenschaften zu speichern. Das hat jedoch die Metadaten überladen und die Pflege erschwert.
Der Kompromiss besteht darin, dass eine durchsuchbare Seitenbibliothek keine Metrikdefinitionen erzwingt oder eine semantische Ebene ersetzt. Sie benötigt dennoch klar benannte Besitzer/-innen, aktuelle Quellenreferenzen und einen Überprüfungsprozess, weshalb wir den unten beschriebenen Überprüfungs- und Priorisierungszyklus beibehalten.
Trotzdem war Notion für uns der richtige Ort. Die Personen, die wissen, was eine Zahl bedeutet, schreiben bereits in Notion darüber. So liegt der Kontext direkt bei der Arbeit, durch die er aktuell bleibt. Notion ist dafür aber keine Voraussetzung. Kunden können ihre Datenexpertise weiterhin mit bestehenden Tools verwalten, darunter Snowflake Semantic Views und Cortex Analyst, und sie mit dem Geschäftskontext in Notion verbinden.
Die Routing-Anleitung grenzt die Suche ein, bevor eine Abfrage geschrieben wird, und hält Datendefinitionen von der geschäftlichen Interpretation getrennt. Dies ist ein Beispiel, welche Systeme verbunden sind, hängt von deinem Setup ab.
Kontext nach Domain und Fragetyp organisieren
Unsere Discovery-Anweisungen beginnen mit ein oder zwei relevanten Domains und zugehörigen Fähigkeiten, bevor Tabellen ausgewählt werden. Eine genau passende Fähigkeit mit hoher Priorität oder ein Eintrag in den FAQs kann für eine gezielte Suche ausreichen; der Agent erweitert seine Suche nur, wenn eine Anleitung fehlt.

Der Index hilft ihm, die richtige Seite zu finden und zu verstehen, wofür diese Seite gedacht ist. Diese Felder stammen aus der Discovery-Anleitung; die Beispielwerte dienen der Veranschaulichung.
Feld | Zweck | Beispiel |
|---|---|---|
Titel | Benenne den Eintrag eindeutig | Kontonutzung vor der Verlängerung |
Domain | Grenze den Geschäftsbereich ein | Vertrieb, Produkt |
Typ | Gib an, wie die Seite verwendet werden soll | Fähigkeit, Metrikdefinition, Tabellenschema, FAQs |
Beschreibung / Schlüsselwörter | Absicht und vertraute Begriffe abgleichen | Verlängerung, Nutzung, Kontoüberprüfung |
Priorität | Ordne die relevanten Anleitungen | Vom Team definierte Abrufpriorität |
Jede Zeile öffnet eine Seite mit einheitlichen Überschriften. Ein kurzer Eintrag zu einer Fähigkeit könnte so aussehen:
Der Typ ist wichtig: Eine Fähigkeit liefert das Verfahren, eine Metrikdefinition die Berechnung und ein Tabellenschema die Granularität, Filter, Beitritte und Vorbehalte. Der Eintrag verweist auf die gepflegte Definition, statt eine weitere Version zu erstellen.
Überprüfungsstatus, Aktualität und Besitz sind weiterhin wichtig. Die Priorität steuert die Abrufreihenfolge, nicht die Genehmigung oder den Zugriff.
Wiederholbare Analysen mit klaren Anweisungen ermöglichen
Guter Kontext benötigt dennoch eine konsistente Art der Verwendung. Klare Anweisungen helfen dem Agenten, die richtigen Quellen auszuwählen, seine Arbeit zu überprüfen und anzuhalten, wenn er eine Antwort nicht belegen kann.
Sobald Frage und Quelle geklärt sind, erfordert eine erfolgreiche Ausführung dennoch eine Überprüfung, bevor sie zu einer Antwort wird.

Die Anleitung zur Suche enthält konkrete Hinweise zum Umgang mit Fehlern. Wenn eine erforderliche Spalte nicht dokumentiert ist, prüfe das relevante Schema. Wenn Snowflake einen ungültigen Bezeichner meldet, verifiziere das Schema, statt einen anderen plausiblen Namen auszuprobieren.
Wenn die geladene Anleitung die erforderlichen Felder bereits dokumentiert, kann der Agent sie verwenden, ohne erneut ein breites Schema abzurufen. Dies sind spezifische Entscheidungen darüber, wo ein Abfrage- oder Abrufaufruf getätigt werden soll.
Kläre die Metrik, das Konto oder die Population, den Zeitraum und den Vergleich, bevor du die Berechnung durchführst.
Leite die Anfrage an die genehmigte Verbindung und Quelle weiter und nutze dann die passende Anleitung für die Domain oder die entsprechende Fähigkeit.
Überprüfe die Abfragelogik und die zurückgegebenen Daten, darunter die Kardinalität der Beitritte, Filter, Nenner und unvollständige Zeiträume.
Markiere fehlende Definitionen, verweigerten Zugriff und fehlgeschlagene Prüfungen, statt einen Workaround zu erfinden.
Unterscheide zwischen Unsicherheit über eine Zahl und Unsicherheit über ihre Erklärung.
Beginne mit dem Ergebnis und den Belegen dafür. Lass Zwischenabfragen aus der Hauptantwort weg, sofern sie nicht bei der Überprüfung helfen.
Gehen wir zurück zum Beispiel der Kontonutzung. Bevor Data Scout den Trend anhand des Kontoplans interpretiert, prüft er, ob die Messung selbst Bestand hat:
Entitätsprüfung: Die Zuordnung von Konto zu Workspace deckt den betreffenden Kunden ab, ohne Personen oder Aktivitäten doppelt zu zählen.
Metrikprüfung: Zähler, Nenner, Ausschlüsse und Zeiträume folgen der gepflegten Definition.
Datenprüfung: Der Zeitraum ist vollständig genug für einen Vergleich, und bekannte Tracking-Änderungen oder Backfills werden berücksichtigt.
Snapshot-Prüfung: Wenn eine Quelle pro Entität und Tag eine Zeile enthält, verwendet eine Abfrage des aktuellen Zustands ein Stichdatum. Über mehrere Tage hinweg kann dieselbe Entität mehrfach gezählt werden. Deshalb verwenden wir einen solchen Zeitraum nur für eine ausdrückliche Trendanalyse.
Interpretationsprüfung: Die Antwort unterscheidet die gemessene Änderung von einer möglichen Erklärung in Rollout-Notizen oder Kundengesprächen.
Der Account Manager kann Nachfragen stellen und die Quellen überprüfen. Das Kundenbetreuungsteam trifft weiterhin die Entscheidung.
Daten und Geschäftskontext aktuell halten
Sowohl die Daten als auch das Geschäft verändern sich ständig. Die zugehörigen Leitlinien müssen deshalb ebenfalls aktuell bleiben. Der Datenkontext ändert sich mit Modellen, Definitionen und Quellsystemen, der Geschäftskontext mit Plänen, Entscheidungen und Kundenaktivitäten. Bei Notion pflegen wir diese Anleitung mit eng abgegrenzten Custom Agents statt mit Datenbankautomatisierungen. Jede Nacht prüft ein Review-Agent die Unterhaltungen und Abfragen des Data-Scout sowie Slack, Notion und GitHub auf fehlenden, veralteten oder widersprüchlichen Kontext und hält die Ergebnisse fest. Anschließend entfernt ein Priorisierungs-Agent Duplikate, nimmt kleine, gut belegte Korrekturen vor und leitet mehrdeutige oder riskantere Fälle zur weiteren Überprüfung an eine Person weiter.

Dieser Überprüfungsprozess trennt den Nachweis einer Änderung von der Berechtigung, sie anzuwenden.
Nachweis ist keine Genehmigung. Eine Slack-Korrektur ist ein Grund zur Untersuchung, keine Berechtigung, eine Metrik umzuschreiben.
Zusammengeführt heißt nicht bereitgestellt. Ein PR beweist nicht, dass die Änderung live ist oder historische Daten nachgetragen wurden.
Vor der Wiederverwendung eine Rezension durchführen. Wende nur autorisierte Änderungen an, erhalte neuere Bearbeitungen von Menschen und verifiziere alle Updates. Gib unklare oder folgenreiche Änderungen an die zuständigen Besitzer/-innen weiter.
Im Adoptionsbeispiel kann ein umbenanntes Ereignis oder ein geklärter Vorgang eine Aktualisierung der Leitlinienquelle erfordern. Der antwortende Agent sollte diese geprüfte Aktualisierung verwenden, statt beim Antworten stillschweigend seine eigene Definition umzuschreiben. Die begleitende Leitlinie beschreibt den Überprüfungs- und Priorisierungs-Workflow genauer.
Sehen, was der Agent tatsächlich getan hat
Unser Wrapper für die Abfrageausführung, run_tagged_query, kombiniert Metadaten und Ausführung in einem Aufruf. Er ergänzt strukturierte Metadaten als JSON-Kommentar im SQL und ruft dann intern das vorgelagerte Snowflake-Abfragetool auf.
Die Metadaten können die kanonische Metrik, den Definitionsverweis, Kontextseiten, Filter, das Zeitfenster und die Fragen-ID enthalten. Ein SQL-Kommentar ist nicht Snowflakes nativer QUERY_TAG-Sitzungsparameter. Wenn die Ausführungsebene eine stabile Snowflake-Sitzung steuert, kann sie dieselben Metadaten auch als QUERY_TAG setzen. So lässt sich die Zuordnung in ACCOUNT_USAGE.QUERY_HISTORY direkt filtern. Gehe nicht davon aus, dass separate Tool-Aufrufe dieselbe Sitzung nutzen. Bei gepoolten Sitzungen muss das Tag außerdem zuverlässig ersetzt oder gelöscht werden, um Fehlzuordnungen zu vermeiden.
Diese Traces helfen uns, die Analyse zu untersuchen und zu entscheiden, wo Verbesserungen angebracht sind.
Verwenden äquivalente Fragen die beabsichtigten Definitionen und den beabsichtigten Umfang?
Deuten Fehler auf fehlenden Kontext, die falsche Quelle oder ein Ausführungsproblem hin?
Wo werden Abfragen oder Kontextabrufe unnötigerweise wiederholt?
Welche wiederkehrenden Fragen erfordern ein wiederverwendbares Analysemuster oder einen Bericht?
Wenn die Adoptionsfrage unterschiedliche Antworten liefert, kann der Trace dabei helfen, eine abweichende Kontenzuordnung, einen Populationsfilter oder ein Zeitfenster aufzudecken. Wir können dann untersuchen, ob die Korrektur in die Datendefinition, das Routing oder die Validierungsanweisungen gehört.
Wir verbessern weiterhin die Überprüfung von Antworten, die von den Besitzer/-innen der Daten validiert wurden. Dazu testen wir Änderungen am Kontext und an den Anweisungen anhand derselben repräsentativen Fragen und verwenden bei Bedarf feste Zeiträume oder Snapshots. Erfolgreiche Abfragen und eine steigende Nutzung sind nützliche Signale, beweisen aber nicht, dass die Antworten korrekt sind.
Diese Traces sind nützlich, haben aber ihre Grenzen. Konsistenz bedeutet nicht identisches SQL. Äquivalente Abfragen können unterschiedlich aussehen, und unterschiedliche Berechtigungen können legitimerweise zu unterschiedlichen Ergebnissen führen, daher vergleichen wir stattdessen die Definition, den Umfang und den Zeitraum. Schreibgeschützte Abfragen verbrauchen dennoch Ressourcen, daher halten wir die Tools fokussiert und die Untersuchungen begrenzt. Mehr Abrufe oder Wiederholungen verbessern eine Antwort nicht automatisch. Der Wrapper ist zudem standardmäßig tolerant, sodass eine unvollständige Zuordnung eine gültige Abfrage nicht blockiert. Strengere Metadatenprüfungen können aktiviert werden, aber keiner der beiden Modi beweist, dass eine Antwort korrekt ist, und keiner ändert Datenberechtigungen.
Einen eigenen Daten-Agent erstellen
Starte mit einer kleinen Auswahl wiederkehrender Fragen, die auf genehmigten Daten und gepflegten Anleitungen beruhen. Entscheide anhand dieser Fragen, was der Agent benötigt, anstatt zuerst das gesamte Unternehmen dokumentieren zu wollen.
Wähle zulässige Daten und Definitionen, denen die Besitzer/-innen der Daten vertrauen.
Verknüpfe relevantes Business-Wissen und mache den Analyseprozess transparent.
Prüfe die Arbeit und halte einen Prozess für die Überprüfung von Korrekturen bereit, während sich das System weiterentwickelt.
Wenn du mehr darüber erfahren möchtest, wie wir das bei Notion eingerichtet haben, findest du in unserer Anleitung im Hilfe-Center Informationen zu den von uns genutzten Optionen für Verbindungen, Beispielanweisungen, Routing-Hinweisen, Wartungs-Workflows und Beispielen für Abfrageprotokolle.
Wenn du einen Daten-Agent für dein Team erstellen möchtest, bieten wir ein Early-Access-Programm an, in dem wir unseren Kunden helfen, Snowflake-gestützte Notion Agents einzurichten. Melde dich bei uns!