
以前、Notionでデータについて質問すると、いつも同じところで行き詰まっていました。データチームの時間が足りなかったのです。誰かがSlackに質問を投稿すると、データサイエンティストが依頼内容を確認し、対応の優先度を判断して、適切なデータソースを探し、定義を確認してクエリを書き、結果を説明していました。よくある質問でも数日かかることがありました。
この流れを短くするため、社内向けのデータエージェント「Data Scout」を構築しました。今ではNotionの誰もが自然言語で質問し、Snowflakeの管理されたデータに基づく回答を得られます。導入から2か月以内に、データチームへの週あたりの依頼件数は約80%減りました。以前は順番待ちだった質問にも、今では数分で答えが出ます。
この変化により、データチームは時間を取り戻すことができました。同じ数値を繰り返し抽出したり、同じ分析のバリエーションを実行したりする代わりに、判断力と専門知識が求められる、より高度な業務に集中できるようになりました。
現在、Notionの従業員の約半数がData Scoutを使っています。しかし、もっと大きく変わったのは働き方です。チームはリサーチやレポートの作成、会議の準備をしながら、Data Scoutで数値を取得しています。「Data Scoutに聞きましたか?」とチームで確認することも珍しくありません。意思決定にデータを取り入れるために、チケットを起票して回答を待つ必要はもうありません。
私はData Scoutの構築に携わったデータエンジニアです。この記事は、私たちがなぜData Scoutを作り、何が変わったのかを知りたいビジネスリーダーと、どう作ったのかを知りたいデータエンジニア仲間に向けて書きました。まず、現在チームがData Scoutをどう使っているかを紹介し、その後で技術上の選択とトレードオフについて説明します。
NotionのチームがData Scoutをどのように利用しているか
Data Scoutは、Snowflakeの管理されたデータを、Notion内の社内ナレッジやSlackなどの接続されたソースと結び付けます。Snowflakeがデータへのアクセス権限を適用する一方で、Notionはエージェントとそのツールへのアクセスを制御し、各依頼を理解するために必要なビジネスコンテキストを提供します。
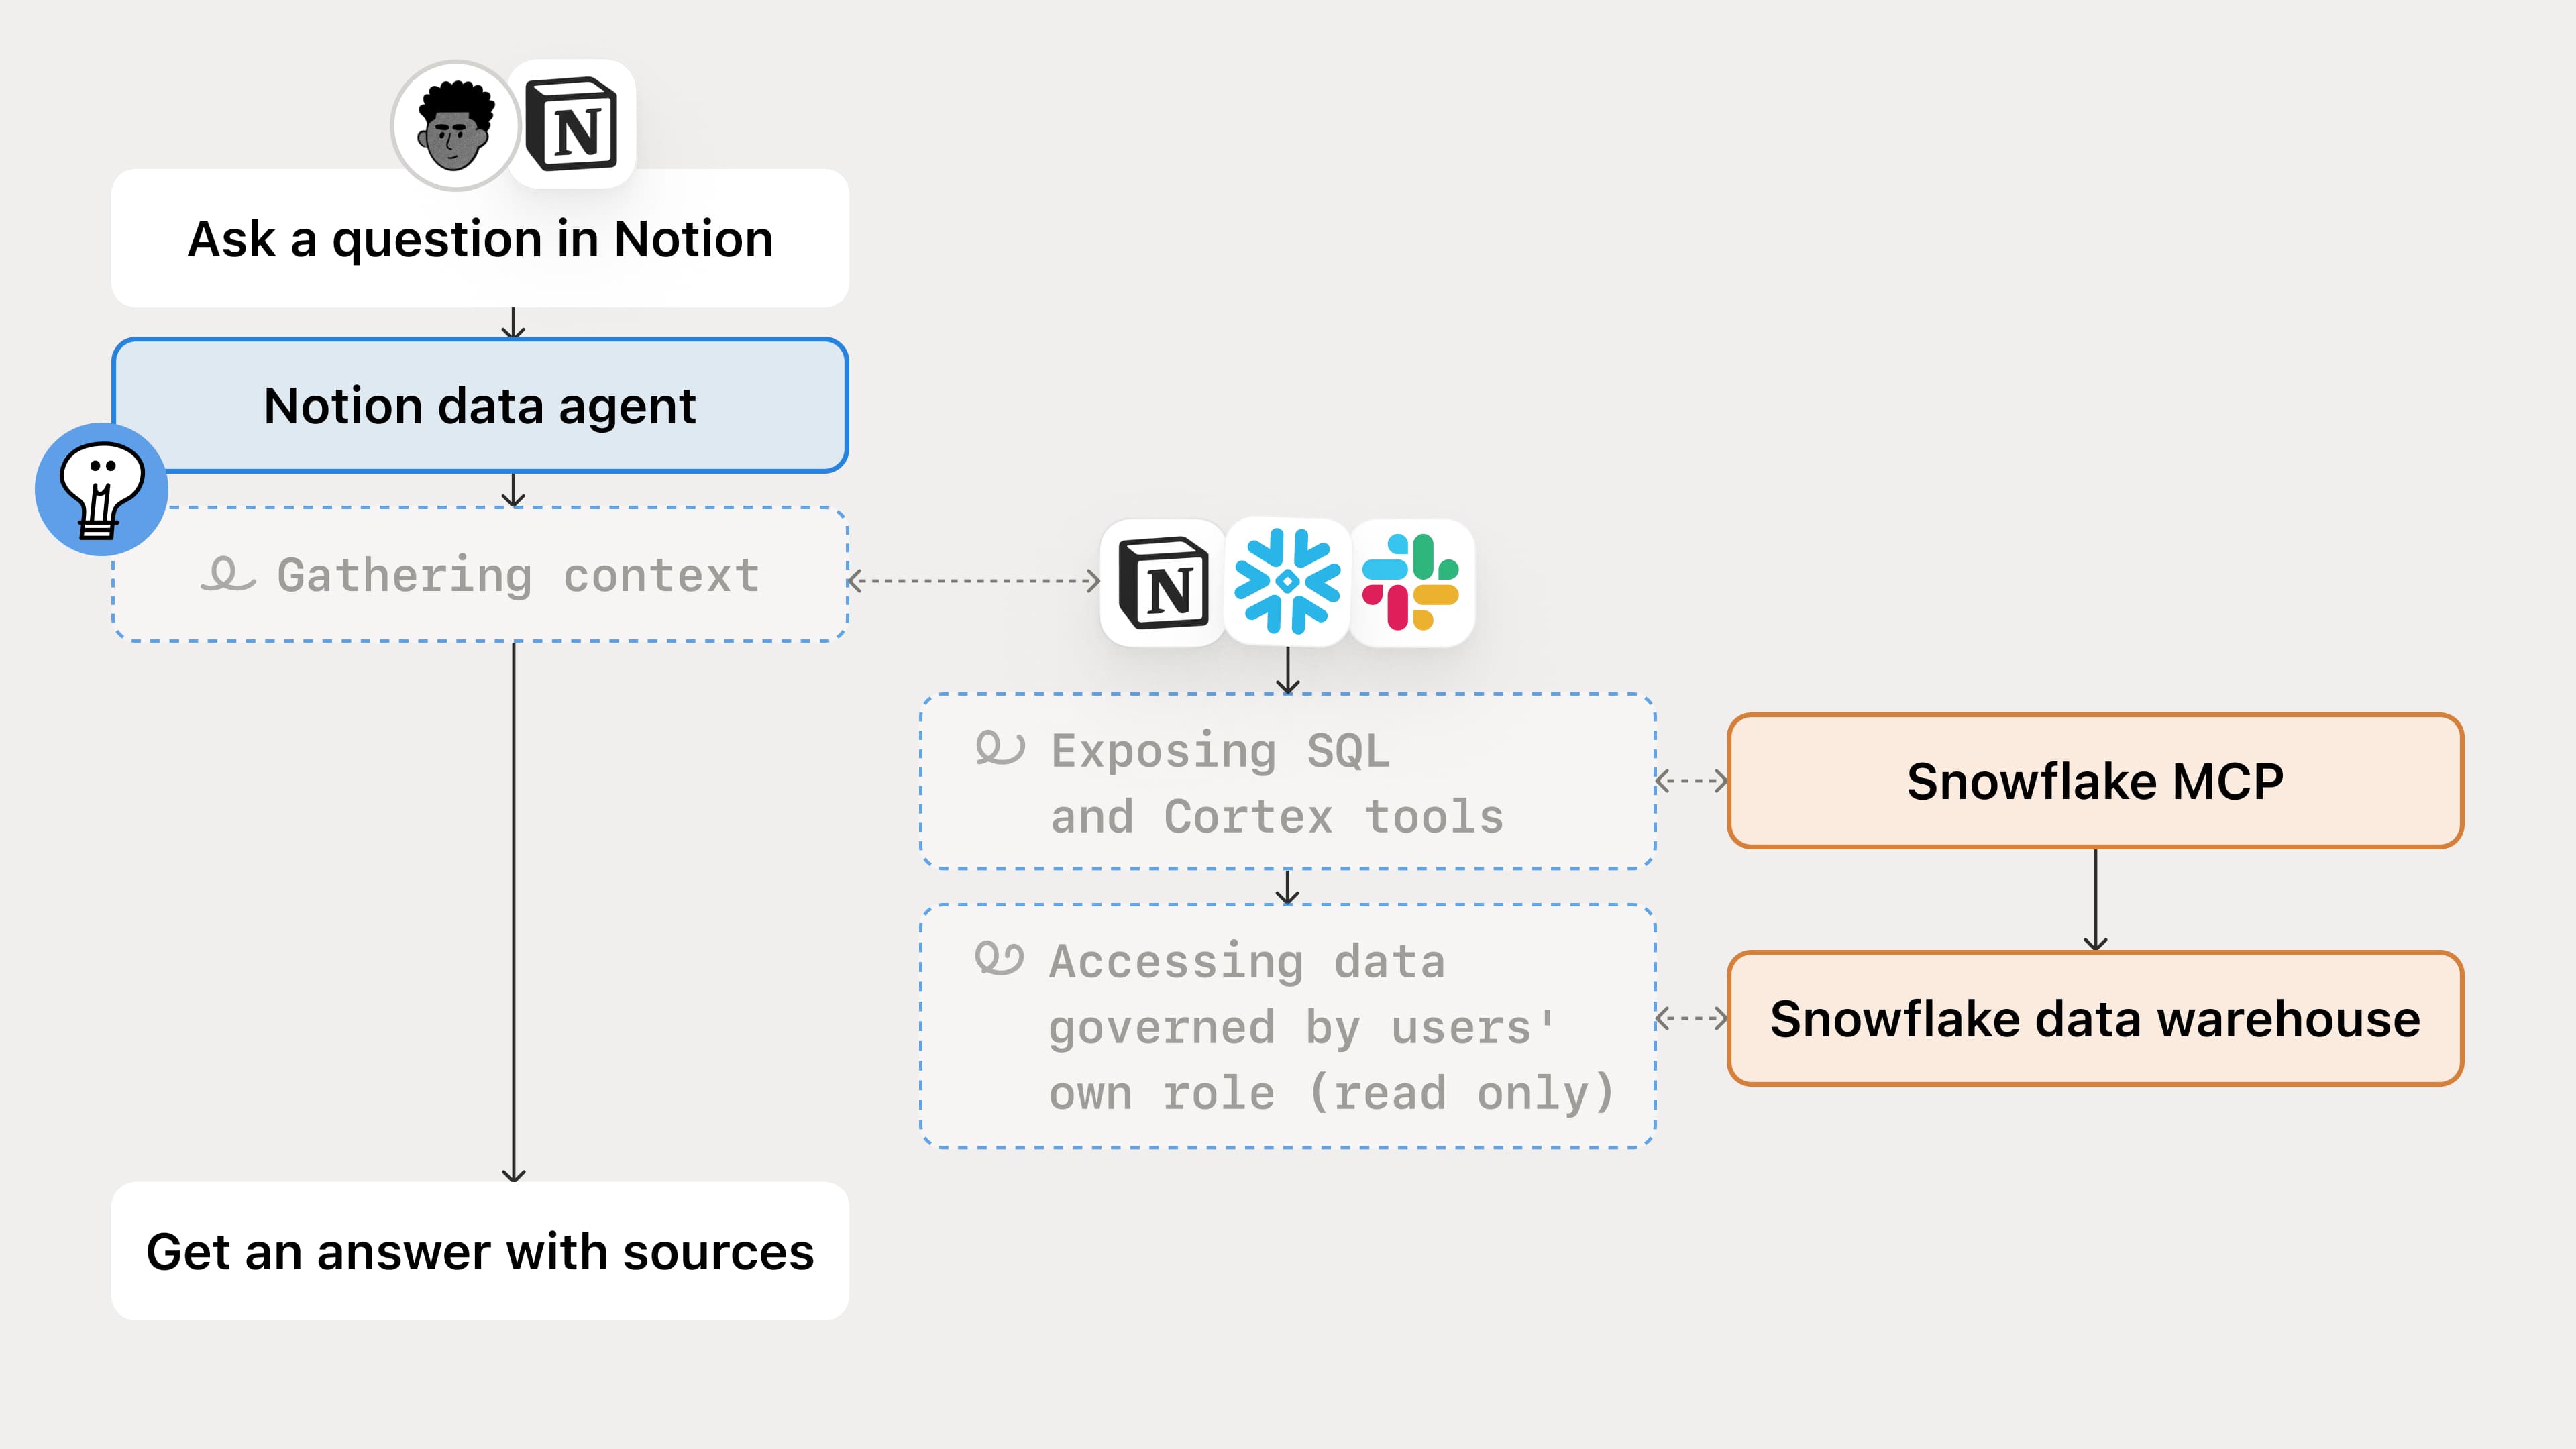
この共有基盤と権限モデルにより、多くのチームが同じエージェントをさまざまな意思決定に利用できます。営業チームはアカウントの利用状況について質問し、プロダクトチームはオンボーディング中の離脱を調べ、カスタマーエクスペリエンスチームはサポートの問い合わせ件数を調査できます。
Data Scoutに対する200件の実際の質問をサンプルとして抽出したところ、最も一般的なテーマは以下の通りでした。
チーム | 繰り返し発生する作業 | 代表的な質問 |
|---|---|---|
営業 | アカウントの利用状況、AIの導入状況、シート数、ARR、パイプライン、およびオーナーシップ | このアカウントは、ワークスペース全体でNotionとAIをどのように利用していますか? |
エンジニアリング | プロダクトとAIの動作、ユーザーIDなどの照会、データ検証 | どのエージェントやワークスペースが引き続きアクティブで、どこで利用動向が変化しましたか? |
カスタマーエクスペリエンス | チケットの件数、初回応答時間、CSAT、および顧客のコンテキスト | このサポートキューの問い合わせ件数と応答時間に影響している要因は何ですか? |
プロダクト | 機能の導入、オンボーディング、アクティベーション、およびコンバージョン | ユーザーはオンボーディングのどの段階で離脱し、その傾向はコホートによってどう異なりますか? |
マーケティング | ターゲットアカウントの選定、顧客による導入状況、キャンペーン、パイプライン | どのターゲットアカウントがすでにNotion AIを使用しており、どこにアウトリーチを集中させるべきでしょうか? |
GTMチームの例:アカウントでの導入状況を把握する
これらの要素がどのように組み合わさるかを示すために、GTMチームのメンバーが顧客の契約更新に向けて準備する様子を見てみましょう。
あるチームメイトは、「このアカウントでAIの導入は進んでいますか?」と尋ねます。有益な回答には、適切な利用指標とアカウントの対象範囲に加え、顧客の目標と計画されているAIのロールアウトについての情報が必要です。Data Scoutは、Snowflakeの利用データとNotionのアカウントに関するメモや過去の会議の記録を組み合わせ、導入状況が顧客の計画と一致しているかどうかを示します。
最初の回答から、さらに質問が生まれることもよくあります。「AIの導入が進んでいるのはどのチームですか?」「利用が伸びているのは新規ユーザーが増えたからですか、それとも既存ユーザーの利用が深まったからですか?」追加の質問のたびに新たなデータ調査を依頼しなくても、アカウントマネージャーは同じ会話の中でデータを掘り下げられます。そのため、何が変わったかを十分に把握して契約更新の会議に臨めます。
1つのデータエージェントから、定期的なワークフローと専門特化したワークフローへ
こうした臨時の質問は、まだ始まりにすぎませんでした。やがて各チームは、Data Scoutの共有されたMCP接続を通じてData Scoutにつながるエージェントを構築し、権限に基づくデータへのアクセスと社内情報を活用するようになりました。そこから、次の2つの使い方が生まれました。
定期的な分析:Data Scout ReporterはData Scoutに接続し、保存したレポートの定義をもとに、スケジュールに沿ってNotionとSlackにレポートを届けます。チームは毎週分析を実行しなくても、同じ指標を継続して追跡できます。
ドメイン固有の専門知識:各チームは、Data Scoutの管理されたデータとコンテキストを活用しつつ、独自のワークフローに関する詳細なガイダンスを組み込んだ専門エージェントを構築しました。
Data ScoutはNotionで最も利用されている社内エージェントですが、このような関連エージェントも独自に人気を集めています。前者は臨時の質問に利用し、後者はその基盤をチーム固有の繰り返し実行できるワークフローに取り入れます。しかし、より多くのチームやエージェントが同じ基盤を再利用するようになるにつれ、回答の信頼性を維持することがより困難な課題となりました。
SQLが機能するだけでは不十分な理由
クエリが問題なく実行されても、意図とは違う問いに答えてしまうことがあります。難しいのは、質問をクエリにし、クエリから回答を出すまで、ビジネス上の意味を正しく保つことです。導入状況についての質問を例に見てみましょう。SQLが正しく動いても、回答は次の4つの点で間違う可能性があります。
意味が間違っている可能性がある。1人が複数のワークスペースに所属している場合、ユーザーの実人数ではなく、ワークスペースごとの所属人数を合計すると、導入状況が過大評価される可能性があります。
ルーティングが間違っている可能性がある。エージェントは、継続的に管理・更新されている定義や必要なフィルターを見つけないまま、もっともらしいテーブルや接続を見つけてしまうことがあります。
測定が間違っている可能性がある。利用状況の追跡方法が変わったり、過去のデータが修正されたりすると、顧客の実際の行動は変わっていないのに、導入が進んだり後退したりしたように見えることがあります。
解釈が間違っている可能性がある。正しい数値であっても誤読される可能性があります。顧客がチームごとにAIを導入している場合、横ばいに見える導入状況もプランどおりかもしれません。導入状況のコンテキストはSnowflakeではなく、Notionのアカウントのメモや過去の会議の記録にあります。
私たちが得た教訓は明確です。適切に整理されたコンテキストは、接続そのものと同じくらい重要です。データへのアクセスがあるだけでは、どの定義を信頼すべきか、どのソースを使用すべきか、あるいは結果がビジネスにとって何を意味するのかをエージェントは判断できません。その知識にはオーナーが必要であり、常に最新の状態に保つ方法も必要です。
データエージェントの構築とガバナンスの方法
私たちは、管理されたエージェントとデータアクセス、共有データコンテキスト、明確な指示を中心に構築しています。これらが組み合わさることで、エージェントの権限、使用する知識、そして従うべきプロセスが定義されます。

柱となる要素だけでは、回答の信頼性は確保されません。私たちは結果を検証し、エージェントがどのようにその結論に至ったかを調査し、データやビジネスの変化に応じてガイダンスを更新します。
エージェントとそのデータアクセスの管理
NotionとSnowflakeは、ワークフローの異なる部分を管理します。Notionはワークスペースへのアクセスと利用可能なツールを管理し、Snowflakeはクエリを実行するユーザーIDに対してデータアクセス権限を適用します。
ユーザーはSnowflake MCPに接続できます。その際、カスタムエージェントまたはNotion Agentを経由します。どちらの接続方法でも、各ユーザーは自身の認証情報を使用してSnowflakeにサインインする必要があります。これにより、クエリはそのユーザーの認証されたSnowflake IDで実行され、回答にはそのユーザー個人のデータアクセス権限が反映されます。
Snowflakeのデータ制御はロールと権限を強制します。設定に応じてマスキングや行レベルのポリシーが適用され、ワークフローに必要なデータとアクションに権限が制限されます。
アカウントマネージャーのクエリは、接続に設定されたデータアクセス権限に従う必要があり、その結果は共有されるレポートやチャネルに適したものでなければなりません。エージェントは見つけにくかったデータを提示するかもしれませんが、アクセス制御をバイパスすることはありません。
データとビジネスコンテキストの接続
共有データコンテキストは、エージェントが同じ定義とデータソースに関する指針を参照できるようにします。Notionはビジネスコンテキストのハブです。ここには、エージェントが質問の意味をよりよく理解するために使用できるプラン、決定、顧客知識が含まれています。
参照先が同じ場所にあっても、それぞれの役割は明確に分けています。
データコンテキストは、指標、ソース、粒度、リレーション、必要なフィルタ、鮮度など、計算に関する事項を規定します。
ビジネスコンテキストは、目標、社内用語、顧客履歴、および結果の解釈に役立つ可能性のあるイベントを説明します。
ルーティングガイダンスは、承認済みの適切なソース、接続、ツールを選び、関連するコンテキストを見つけます。対象は1つのウェアハウス内のテーブルに限らず、複数のSnowflake接続や異なるプラットフォームにまたがる場合もあります。
私たちは、定義、スキーマ、スキル、および既知のデータ変更の共有インデックスとしてNotionデータベースを使用しています。各行はページでもあります。そのプロパティはエージェントが関連するガイダンスを見つけるのに役立ち、本文にはエージェントが使用する必要のある定義、手順、注意点、または参照が含まれています。
エージェントはデータベース全体を読み込むのではなく、選んだページの本文を読み、関連する参照先をたどります。メタデータは適切なコンテキストを見つける助けになりますが、そのコンテキストに代わるものではありません。定義が別の場所にある場合は、コピーを作らず、その定義が管理されているソースをエントリから参照できるようにします。
私たちがNotionを選んだのは、チームがすでに維持しているプラン、意思決定、顧客に関する知識のそばにコンテキストを置けるからです。エージェントは、指標の定義とそれを説明するアカウントのメモを同じワークスペース内で読み取ることができます。オーナーはNotionの既存の権限を使用して使い慣れたページを編集・共有でき、エージェントはプロパティを通じてエントリを見つけ、ページ本文を読み取ることができます。検索を高速化するためにすべてのガイダンスをデータベースのプロパティに入れることも試しましたが、メタデータに情報を詰め込みすぎることになり、維持管理が困難になりました。
そのトレードオフとして、検索可能なページライブラリには、指標定義の遵守を強制する機能はなく、セマンティックレイヤーの代わりにもなりません。依然として明確なオーナー、最新のソース参照、およびレビュープロセスが必要であり、そのため以下に説明するレビューとトリアージのループを維持しています。
それでも、Notionは私たちにとって適切なホームでした。数値の意味を理解している人々が、すでにNotionにその情報を記録しているため、コンテキストはそれを最新の状態に保つ作業のそばにあります。ただし、Notionの使用は必須ではありません。お客様は、Snowflake Semantic ViewsやCortex Analystを含む既存のツールにデータに関する専門知識を保持し、それをNotionのビジネスコンテキストに接続することも可能です。
ルーティングガイドは、クエリが作成される前に検索範囲を絞り込み、データ定義をビジネス解釈から分離します。これはパターンの一例であり、接続されるシステムはお客様のセットアップによって異なります。
ドメインおよび質問タイプ別のコンテキストの整理
私たちの探索の指示では、テーブルを選ぶ前に、関連する1つか2つのドメインとスキルを確認します。優先度が高く、質問にぴったり合うスキルやよくあるご質問(FAQ)があれば、特定の値やレコードを検索するには十分な場合があります。エージェントはガイダンスが不足している場合にのみ、検索範囲を展開します。

インデックスは、適切なページを見つけ、そのページが何のためのものかを理解するのに役立ちます。これらのフィールドはディスカバリーガイダンスから取得されます。例の値は説明用です。
フィールド | 目的 | 例 |
|---|---|---|
タイトル | エントリに明確な名前を付ける | 更新前のアカウントの導入状況 |
ドメイン | ビジネス領域を絞り込む | 営業、プロダクト |
タイプ | ページの使用方法を示す | スキル、指標定義、テーブルスキーマ、よくあるご質問(FAQ) |
説明 / キーワード | 意図やよく使う用語に合わせる | 更新、導入、アカウントレビュー |
優先度 | 関連するガイダンスに優先順位を付ける | チームが定義した検索優先度 |
各行を開くと、見出しが統一されたページが表示されます。短いスキルのエントリは、次のようになります。
タイプは重要です。スキルは手順を提供し、指標定義は計算を提供し、テーブルスキーマは粒度、フィルター、結合、および注意事項を提供します。エントリは、別のバージョンを作成するのではなく、維持されている定義を指します。
レビューのステータス、情報の鮮度、オーナーが明確かどうかも重要です。優先度が決めるのは検索順序であり、承認やアクセスではありません。
再現可能な分析のための明確な指示
優れたコンテキストがあっても、それを一貫して活用する方法が必要です。明確な指示は、エージェントが適切なソースを選び、作業内容を確認し、回答を裏付けられない場合に作業を止めるのに役立ちます。
質問とソースが明確になっても、実行結果を回答にする前に、その結果を確認する必要があります。

ディスカバリーガイドには、失敗時の具体的な対処方法が含まれています。必要な列が文書化されていない場合は、関連するスキーマを調べてください。Snowflakeから無効な識別子が報告された場合は、もっともらしい別の名前を試すのではなく、スキーマを検証してください。
読み込んだガイダンスに必要なフィールドがすでに記載されていれば、エージェントは広範なスキーマを再取得せずにその情報を使えます。これは、クエリの実行や情報取得の呼び出しをどの処理に使うかという具体的な判断です。
計算を行う前に、指標、アカウントまたは母集団、期間、および比較対象を確定させてください。
承認された接続とソースにルーティングし、関連するドメインガイダンスまたはスキルを使用してください。
クエリのロジックと返されたデータを確認してください。これには、結合のカーディナリティ、フィルター、分母、不完全な期間などが含まれます。
回避策を考案するのではなく、定義の欠落、アクセス拒否、チェックの失敗をフラグ付けしてください。
数値に関する不確実性と、その説明に関する不確実性を分けて考えてください。
結論とそれを裏付ける証拠を先に提示してください。中間的なクエリは、読者が確認するのに役立つ場合を除き、メインの回答には含めないでください。
アカウント導入の例に戻りましょう。Data Scoutがアカウントプランを通じてトレンドを解釈する前に、測定自体が妥当であるかを確認します。
エンティティチェック:アカウントとワークスペースのマッピングが、ユーザーやアクティビティを重複させることなく、対象の顧客を網羅していることを確認します。
メトリックチェック:分子、分母、除外項目、および期間が、継続的に管理・更新されている定義に従っていることを確認します。
データチェック:比較に十分な期間のデータがそろっており、既知のトラッキング方法の変更や過去データの補完が考慮されていることを確認します。
スナップショットチェック:ソースにエンティティごとに1日1行のデータがある場合、現在の状態を調べる際は基準日を1つに絞ります。複数日の範囲を使うと同じエンティティを繰り返し数える可能性があるため、明示的に推移を見る場合にのみ使用します。
解釈チェック:回答において、測定された変化と、ロールアウトのメモや顧客との会話における考えられる説明とを区別します。
アカウントマネージャーは追加で質問し、ソースを確認できます。判断は引き続きアカウントチームが行います。
データとビジネスコンテキストを最新の状態に保つ
データもビジネスも変わり続けるため、それらに関するガイダンスも最新の状態に保つ必要があります。モデル、定義、ソースシステムが変わればデータのコンテキストが変わり、プラン、意思決定、顧客のアクティビティによってビジネスのコンテキストも変わります。Notionでは、データベースのオートメーションではなく、対象範囲を限定したカスタムエージェントでこのガイダンスを管理しています。毎晩、レビューエージェントがData Scoutの会話やクエリ、Slack、Notion、GitHubを確認し、不足、古さ、矛盾のあるコンテキストを探して、見つけた内容を記録します。その後、トリアージエージェントが重複を取り除き、十分な裏付けがある小さな修正を加え、曖昧なものやリスクの高いものは担当者に送ってレビューを依頼します。

このレビュープロセスでは、変更の証拠と、それを適用する権限とを区別します。
証拠は承認ではありません。Slackでの修正は調査の理由にはなりますが、メトリックを書き換える権限にはなりません。
マージされてもデプロイされたとは限りません。PRだけでは、変更が本番環境に反映されたことや、過去のデータが補完されたことを証明できません。
再利用の前にレビューします。承認された変更のみを適用し、人間による新しい編集を保持し、更新内容を検証してください。不明確な変更や重大な影響を及ぼす変更は、オーナーに確認してください。
導入の例では、イベント名の変更や解決済みのインシデントに伴い、ソースに関するガイダンスの更新が必要になる場合があります。回答するエージェントは、回答中に独自の定義を勝手に書き換えるのではなく、レビュー済みの更新内容を使う必要があります。関連ガイドでは、レビューとトリアージのワークフローを詳しく説明しています。
エージェントの実際の動作を確認する
私たちのクエリ実行ラッパーであるrun_tagged_queryは、メタデータと実行を1つの呼び出しにまとめます。これは、構造化されたメタデータをSQL内のJSONコメントとして追加し、内部でアップストリームのSnowflakeクエリツールを呼び出します。
メタデータには、正規のメトリック、定義リファレンス、コンテキストページ、フィルター、期間、質問IDを含めることができます。SQLコメントは、SnowflakeのネイティブなQUERY_TAGセッションパラメーターではありません。実行レイヤーが安定したSnowflakeセッションを制御している場合、同じメタデータをQUERY_TAGとして設定することもでき、ACCOUNT_USAGE.QUERY_HISTORYで、各クエリがどの質問や処理に対応するかを直接フィルタリングできるようになります。個別のツール呼び出しがセッションを共有していると想定しないでください。プールされたセッションでも、誤った帰属先への紐付けを避けるためにタグを確実に置き換えるかクリアする必要があります。
これらのトレースは、分析を調査し、どこに改善の余地があるかを判断するのに役立ちます。
同等の質問では、想定された定義と対象範囲が使われていますか?
失敗の原因は、コンテキストの欠如、誤ったソース、または実行上の問題のいずれですか?
クエリやコンテキストの検索が不必要に繰り返されているのはどこですか?
繰り返し寄せられる質問のうち、再利用できる分析パターンやレポートが必要なのはどれですか?
導入に関する質問で異なる回答が生成される場合、トレースを確認することで、異なるアカウントマッピング、母集団フィルター、または期間が明らかになることがあります。その後、修正がデータ定義、ルーティング、検証指示のいずれに必要なのかを調査できます。
データオーナーが検証した回答との照合方法は、現在も改善を進めています。そのため、必要に応じて期間を固定したりスナップショットを使ったりして、同じ代表的な質問でコンテキストや指示の変更をテストします。クエリの成功や利用の増加は参考になりますが、それだけでは正確性を証明できません。
これらのトレースは役立ちますが、限界もあります。一貫性があるからといって、SQLが同一とは限りません。同等のクエリでも見た目が異なる場合があり、権限の違いによって結果が異なるのも妥当な場合があります。そのため、定義、範囲、期間を比較します。読み取り専用のクエリでもリソースを消費するため、使うツールを絞り、調査の範囲を限定します。検索や再試行を増やしても、回答が必ず改善するわけではありません。また、ラッパーはデフォルトでチェックが緩やかに設定されているため、クエリの関連付け情報が不完全でも、有効なクエリの実行は妨げられません。より厳格なメタデータチェックも有効にできますが、どちらの設定でも回答の正しさは証明できず、データへのアクセス権限も変わりません。
独自のデータエージェントを構築する
まずは、承認済みのデータと継続的に更新されるガイダンスに基づいて、繰り返し寄せられる質問を少数選んでください。最初から会社全体を文書化しようとせず、その質問をもとにエージェントに必要なものを決めましょう。
データオーナーが信頼する、許可されたデータと定義を選択してください。
関連するビジネス知識を接続し、分析プロセスを明確にしてください。
作業内容を確認し、システムの変化に合わせて修正をレビューできる仕組みを維持してください。
Notionでの設定方法について詳しくはこちらをご覧ください。ヘルプセンターのガイドでは、私たちが使っている接続の選択肢、指示の例、ルーティングのガイダンス、メンテナンスのワークフロー、クエリのログ記録の例を紹介しています。
チーム向けのデータエージェントの構築に関心がある方のために、Snowflakeを活用したNotion Agentの設定を支援する早期アクセスプログラムを実施しています。お問い合わせください。